Un vídeo no es un texto largo con música. Si tu agente solo recibe la transcripción, entiende lo que se dice, pero se pierde la interfaz, el montaje, los rótulos, los gestos y ese error que aparece medio segundo en una esquina. Watch, de bradautomates, cubre ese hueco: extrae fotogramas, consigue una transcripción con marcas de tiempo y entrega ambas capas al agente.
TL;DR: El resumen sin rodeos
- Qué hace: convierte YouTube, Loom, TikTok, Vimeo y archivos locales en fotogramas seleccionados más una transcripción con tiempos.
- Lo mejor: el agente deja de deducir la parte visual a partir de lo que oye.
- La pega: depende de yt-dlp, ffmpeg, subtítulos o Whisper. Un cambio de plataforma puede romper una descarga y los fotogramas siguen siendo una muestra.
- La nota: 90/100. Resuelve un problema real con un pipeline transparente y configurable.
En mi prueba local, Watch separó cinco estados visuales útiles y descartó ocho duplicados. Whisper solo recuperó una palabra. Los fotogramas salvaron el análisis que la transcripción no podía sostener.
DaniEn este artículo
| Proyecto | bradautomates/claude-video |
| Licencia | MIT |
| Estado revisado | Versión 0.2.0; 17.165 estrellas; 1.750 forks; revisado el 14 de septiembre de 2026 |
| Compatibilidad | Claude Code, Codex, Cursor, Copilot, Gemini CLI, claude.ai y más de 50 hosts de Agent Skills |
| Dependencias | Python, yt-dlp y ffmpeg; Whisper local, Groq u OpenAI cuando no hay subtítulos |
| Precio | Gratis y de código abierto; la transcripción por API puede tener coste |
| Valoración | 90/100 |
Esta herramienta forma parte de estos recopilatorios: Skills para Claude Code, Codex y otros agentes de código · Recursos para hacer marketing con agentes de IA
El problema que resuelve
Los agentes actuales pueden razonar sobre imágenes y texto, pero una URL de vídeo no siempre llega como una secuencia visual utilizable. La salida fácil es bajar subtítulos y resumirlos. Eso funciona para una entrevista, pero falla en una demo de software, un anuncio o una grabación de pantalla: la frase “como ves aquí” no dice qué botón se pulsó ni qué cambió en la interfaz.
Watch no intenta reproducir vídeo dentro del modelo. Prepara una representación manejable. Primero busca subtítulos. Después descarga el material que necesita, selecciona escenas con ffmpeg y asocia los fotogramas con una transcripción temporal. El agente recibe pruebas visuales y verbales que puede leer con sus herramientas normales.
Cómo se pone en marcha
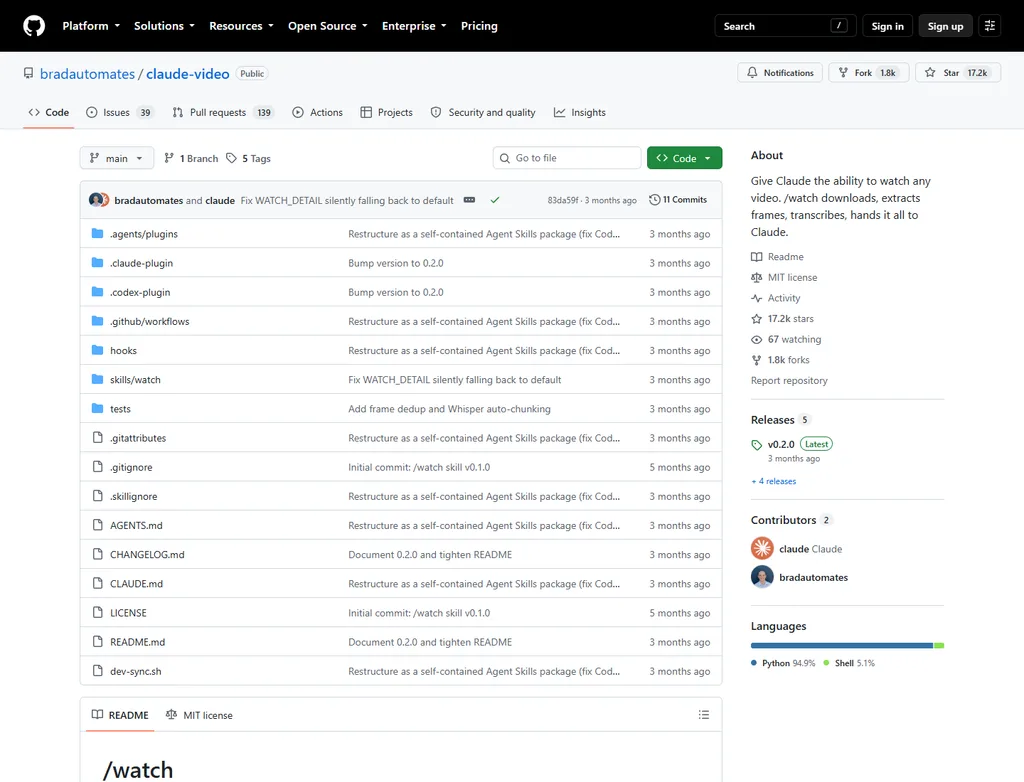
En Claude Code se instala desde el marketplace del autor. En Codex, Cursor, Copilot, Gemini CLI y otros hosts compatibles se distribuye mediante la CLI de Agent Skills.
/plugin marketplace add bradautomates/claude-video
/plugin install watch@claude-video
npx skills add bradautomates/claude-video -gLa primera ejecución comprueba yt-dlp y ffmpeg. En macOS puede instalarlos automáticamente con Homebrew; en Windows y Linux ofrece instrucciones. Si el vídeo trae subtítulos, no hace falta pagar una transcripción. Si no los trae, puede usar faster-whisper de forma local o enviar solo el audio extraído a Groq u OpenAI, según tu configuración.
El control importante es la cantidad de imagen que metes en contexto. transcript usa cero fotogramas; efficient llega hasta 50; balanced, el modo recomendado, hasta 100; y token-burner elimina el tope. También puedes limitar un tramo con --start y --end, pedir marcas concretas con --timestamps o reducir el presupuesto con --max-frames.
Probándolo en un vídeo real
Probé el skill en dos situaciones. Con el enlace público de YouTube que usa su propia documentación como ejemplo, recuperó los subtítulos, pero la descarga de vídeo terminó en un 403. La causa visible era una versión de yt-dlp con más de 90 días y un cambio reciente en la firma de YouTube. Es reparable actualizando la dependencia, pero revela una fricción importante: “cualquier vídeo” significa cualquier vídeo que el extractor pueda obtener hoy.
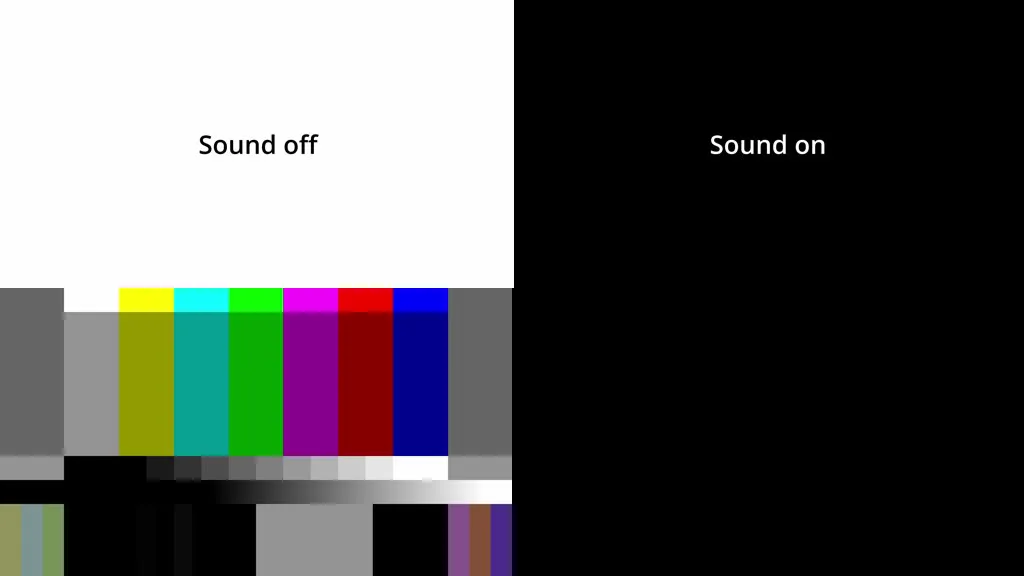
Con un WebM local de 13 segundos funcionó de principio a fin. En modo balanced generó 13 candidatos, descartó 8 casi duplicados y dejó 5 fotogramas. Identificó correctamente los cambios entre “Sound off”, “Sound on”, barras de color y pantalla negra. La transcripción local con Whisper produjo únicamente “you”. Si hubiese pedido un resumen basado solo en audio, el resultado sería inútil; con los fotogramas, la secuencia se entiende.
Para marketing, esta combinación encaja en cuatro tareas: diseccionar el montaje de un anuncio, extraer el recorrido de una demo de producto, localizar el momento exacto de un fallo en una grabación y convertir un tutorial en una checklist. En vídeos largos conviene recortar el intervalo. Cien imágenes repartidas por una hora ofrecen una orientación, no una lectura continua.
Lo que no te cuentan
La primera limitación es epistemológica: Watch no “ve cada fotograma” salvo que fuerces una densidad extrema. Ve una selección. Puede perder un rótulo fugaz, una transición o un cambio pequeño entre dos muestras. El modo sin tope reduce ese riesgo, pero puede devorar contexto. La propia documentación estima que 80 fotogramas de 512 píxeles consumen aproximadamente entre 50.000 y 80.000 tokens de imagen.
La segunda es operativa. yt-dlp persigue plataformas que cambian continuamente. YouTube, TikTok o Instagram pueden exigir una actualización, bloquear una región o pedir autenticación. Que el skill soporte una plataforma no garantiza que todos sus enlaces sean descargables en todo momento.
La tercera es privacidad. Con faster-whisper local, el audio se queda en tu máquina. Con Groq u OpenAI, el vídeo completo no se envía, pero sí el audio extraído cuando hace falta transcribir. Para material de cliente, reuniones o grabaciones internas, esta diferencia debe decidirse antes de ejecutar el skill.
Qué dice la gente
La conversación reciente tiene mucho entusiasmo y bastante marketing de afiliación. El uso que más se repite no es “resumir vídeos”, sino convertir tutoriales en skills reutilizables. Ahí está también la objeción más sensata: para contenido puramente hablado, una transcripción ya resuelve gran parte del trabajo.
Veredicto
Watch merece un 90/100. Hace una cosa muy concreta y la hace de una forma comprensible: convierte vídeo en las dos entradas que un agente maneja bien, imágenes y texto. Sus modos permiten controlar el coste, acepta archivos locales y no obliga a mandar el vídeo entero a un tercero.
No le doy más porque la compatibilidad con plataformas depende de yt-dlp, porque muestrear no equivale a observar cada segundo y porque la calidad de Whisper varía. Lo instalaría si revisas demos, anuncios, tutoriales o grabaciones de errores dentro de Claude Code o Codex. Para podcasts o entrevistas estáticas, empezaría por la transcripción. Para decisiones visuales finas, usaría Watch como mapa y volvería al vídeo como fuente final.
Preguntas frecuentes sobre Watch
¿Watch ve todos los fotogramas de un vídeo?
No. Selecciona escenas y muestras según la duración y el modo. Puedes pedir más densidad o marcas concretas, pero el coste de contexto aumenta.
¿Necesita una clave de OpenAI?
No si el vídeo tiene subtítulos o si configuras faster-whisper local. Groq y OpenAI son opciones de respaldo para transcribir audio sin subtítulos.
¿Funciona en Codex además de Claude Code?
Sí. El repositorio se empaqueta como Agent Skill autocontenido y declara compatibilidad con Codex, Cursor, Copilot, Gemini CLI y más de 50 hosts.
¿Puede analizar vídeos privados?
Puede trabajar con archivos locales que tú proporciones. En plataformas web, el acceso depende de lo que yt-dlp pueda descargar sin iniciar sesión y de las restricciones del enlace.
¿Sustituye ver el vídeo original?
No cuando importan transiciones rápidas, audio, tono o texto pequeño. Es excelente para orientar y estructurar el análisis; la verificación final sigue en el original.