Estamos pagando a modelos de lenguaje que generan párrafos enteros para que nos digan "sí" o "no". Les pedimos que clasifiquen un email y nos devuelven tres líneas de cortesía antes de llegar al punto. TypeSafe acaba de lanzar Jev, un modelo de IA que hace justo lo contrario: recibe un estado con opciones delimitadas, devuelve una decisión estructurada con su distribución de probabilidad en milisegundos y se calla. Que tome decisiones útiles tan rápido y barato. Eso es lo que me importa. Lo he probado en dos tandas: 200 capturas de trabajo real de agencia y 81 peticiones nuevas sobre mensajes de marketing, urgencias operativas y verificación de evidencia. Esto es lo que he encontrado, lo que funciona y lo que no.
TL;DR: El resumen sin rodeos
- Jev no redacta: recibe opciones y devuelve una decisión (Choice, Score o Noul). Si necesitas texto, necesitas otro modelo.
- 0,042 USD por millón de tokens de entrada: la salida es gratuita. 200 peticiones sobre capturas reales costaron 0,0275 USD en total.
- Mediana de 0,39 a 0,77 segundos por decisión: depende del lote y la complejidad de las opciones.
- 19 de 20 acuerdos clasificando mensajes sintéticos de agencia, pero tropieza con entradas ambiguas sin contexto.
- Estructura garantizada no es exactitud garantizada: Jev siempre devuelve una categoría válida. Que acierte depende de tus criterios y de tu revisión.
Que tome decisiones útiles tan rápido y barato.
DaniEn este artículo
- Qué es Jev de TypeSafe AI
- Cómo se usa Jev de TypeSafe AI
- Qué pasó al probar Jev con 200 capturas reales
- Seis usos de Jev en marketing (con ejemplos)
- Cómo Jev ha participado en esta investigación
- Jev con GBrain y los límites de la memoria de IA
- Cuánto cuesta Jev y a qué velocidad responde
- Jev frente a un LLM y las reglas de siempre
- Dónde falla Jev
- Preguntas frecuentes sobre Jev de TypeSafe AI
Qué es Jev de TypeSafe AI
Jev es un modelo de IA de TypeSafe AI, anunciado el 15 de septiembre de 2026. Lo llaman "System One Model": un modelo entrenado para devolver decisiones acotadas, no para generar texto libre.
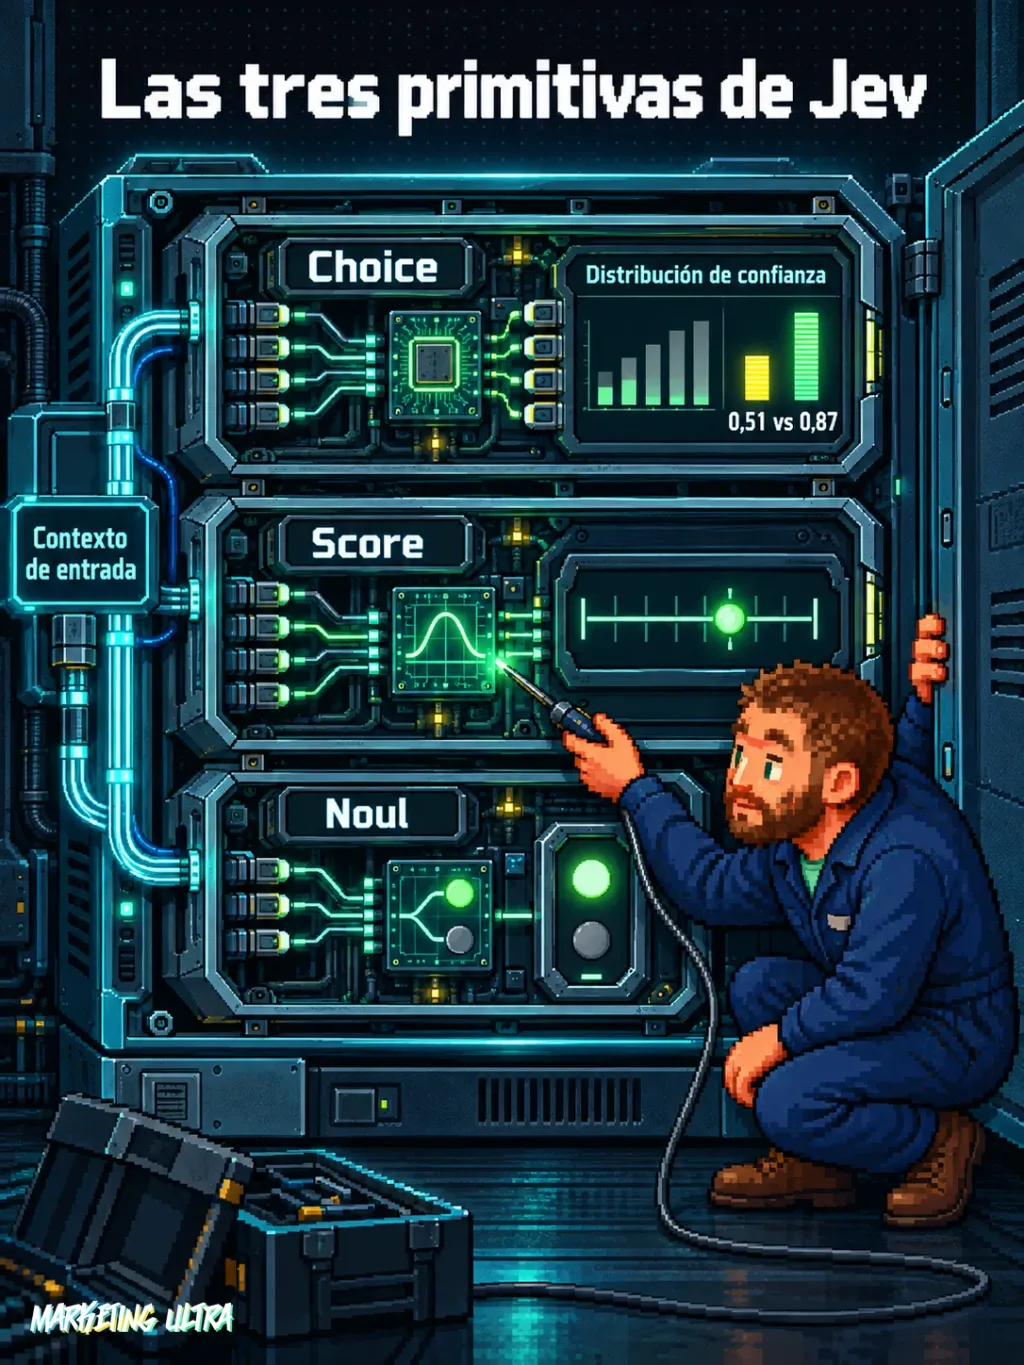
¿Y qué significa eso en la práctica? Que cuando le envías una pregunta con opciones cerradas, Jev elige una y te dice cuánta confianza tiene en cada alternativa. No redacta. No explica. No añade cortesía.
Funciona con tres tipos de pregunta, que TypeSafe llama primitivas:
- Choice: elige una opción entre varias. "¿Este mensaje es de ventas, soporte o facturación?"
- Score: aplica una escala ordenada. "Del 1 al 5, ¿cuánta urgencia tiene esta incidencia?"
- Noul: responde sí o no con una probabilidad. "¿Este fragmento respalda la afirmación del informe?"
En los tres casos, la respuesta es estructurada. SIEMPRE. No hay riesgo de que Jev te devuelva un JSON malformado, se invente un campo o añada un párrafo de explicación no solicitado. Eso es lo que TypeSafe vende como "no alucina": la estructura está garantizada.
Pero ojo: que la estructura sea fiable no significa que la categoría elegida sea correcta. Son cosas muy diferentes. Jev te va a devolver una de las opciones que le has dado, sí. Pero que esa opción sea la correcta para tu negocio depende de cómo hayas definido las categorías, de la calidad del contexto que le envíes y de tu propia revisión.
Cómo se usa Jev de TypeSafe AI
El acceso es a través de la API de TypeSafe, con SDK disponible en Python y TypeScript. También está en Vercel AI Gateway, donde en sus primeras 24 horas llegó a casi el 13% de los equipos de pago y duplicó el ritmo de adopción de cualquier lanzamiento anterior del gateway. Es una señal de interés inicial, no una medición de retención ni de adopción global.
El flujo es siempre el mismo: le das un contexto (el estado), una pregunta y las opciones posibles. Jev devuelve la opción elegida y la distribución de probabilidad de todas las alternativas. Sin decoración.
El patrón: entrada, pregunta, opciones, decisión, acción
Pongamos que un mensaje llega a la bandeja compartida de tu agencia. El ciclo con Jev sería:
- Entrada: el texto del mensaje tal como llega.
- Pregunta: "¿Cuál es la intención principal de este mensaje?"
- Opciones: ventas, soporte, facturación, baja, empleo, aclarar.
- Decisión: Jev elige una categoría y devuelve la confianza en cada opción.
- Acción: tu sistema enruta el mensaje al equipo correspondiente. Jev no ejecuta la acción: solo decide.
Esa secuencia tarda menos de medio segundo y cuesta una fracción de céntimo. Un LLM generativo haría lo mismo, pero más lento y más caro. Y de paso te pegaría un resumen de cortesía que nadie va a leer.
Ojo, que aquí se mezclan piezas: Jev es el modelo. La API es el servicio. El SDK es la librería que simplifica las llamadas. Vercel AI Gateway es un intermediario que añade observabilidad y caché. Y una skill de un agente de código es un conjunto de instrucciones que puede incluir llamadas a Jev como parte de un flujo más grande. No son lo mismo.
Copia esto y pégalo en Claude Code, Cursor o tu asistente de código favorito:
Instala el SDK de TypeSafe AI con pip install typesafe-ai. Configura la API key desde https://typesafe.ai y prueba una decisión Choice que clasifique el mensaje "Quiero cancelar mi suscripción" entre soporte, baja y facturación. Sigue el quickstart en https://docs.typesafe.ai/introduction/quickstart.
No necesitas saber programar. El asistente se encarga de la instalación, la configuración y las pruebas.
Qué pasó al probar Jev con 200 capturas reales
La primera prueba la hice con 200 peticiones sobre capturas de trabajo real de agencia. 40 para desarrollo del lote y las categorías, 160 para evaluación. Modelo fijado en jev-1.13.0. Peticiones secuenciales, sin reintentos automáticos.
Los números:
- 200 peticiones completadas sin errores de API.
- Mediana de latencia: 0,769 segundos por decisión.
- Coste estimado del lote completo: 0,0275 USD. Menos de tres céntimos para 200 decisiones.
En las 38 referencias provisionales no ambiguas que preparé antes de ejecutar, Jev coincidió en las 38. También contrasté sus decisiones con decisiones históricas de Opus sobre las mismas entradas. Coincidieron, que no es lo mismo que decir que Jev sea mejor: no reejecuté Opus en las mismas condiciones ni tengo una latencia comparable. Observación, no referencia controlada.
¿Y lo que más me ha servido del experimento? Que ambos modelos podían reproducir rechazos editoriales discutibles. Es decir: si las categorías o los criterios que definiste son cuestionables, cambiar de modelo no arregla el problema. Solo lo ejecuta más rápido y más barato.
Después de esta primera tanda, ejecuté 81 peticiones adicionales (65 con datos públicos y sintéticos, 16 con verificaciones de evidencia) cuyos resultados detallo en las secciones de marketing y memoria.
Seis usos de Jev en marketing (con ejemplos)
La promesa de Jev encaja en cualquier flujo donde haya que clasificar, puntuar o decidir sí/no muchas veces, rápido y sin necesidad de generar texto. En marketing de agencia hay decenas de esos puntos de decisión. He trabajado seis con detalle: tres con prueba propia sobre datos sintéticos y tres como propuesta con diseño de entrada y salida. Como cuento en la guía de agentes de IA en campañas de marketing, una propuesta con buena pinta y un flujo que funciona son cosas muy diferentes.
1. Clasificar solicitudes de agencia (probado)
20 mensajes sintéticos de agencia. Cada uno llega a la bandeja compartida: ¿es ventas, soporte, facturación, baja, empleo o necesita aclaración? Jev coincidió con la referencia en 19 de 20.
El caso que falló es el más interesante. Ante el mensaje "Presupuesto" (una sola palabra), Jev eligió ventas con confianza 0,51. Mi referencia esperaba "aclarar", porque un mensaje de una palabra no da contexto suficiente. ¿Quiere pedir presupuesto nuevo, consultar uno pendiente o reclamar un cobro?
¿Quién tiene razón? Depende de cómo diseñes las categorías. Jev no se equivoca por devolver ventas: toma la decisión más probable con la información que tiene. El problema es que la información es insuficiente. Un sistema bien montado usaría esa confianza baja (0,51 frente a un 0,87 típico en los mensajes claros) para pedir más contexto antes de enrutar.
2. Urgencia operativa: enfado no es emergencia (probado)
6 mensajes sintéticos diseñados para distinguir cabreo de emergencia real. Una queja airada porque el informe tiene los colores cambiados. Una tienda que no puede procesar pagos. Un cliente que amenaza con irse por un error de facturación.
Resultado: 6 de 6 acuerdos con la referencia. Jev separó la irritación legítima (pero no urgente) del problema que paraliza un negocio.
Son seis ejemplos deliberadamente pequeños y sintéticos. No acreditan que funcione igual en una bandeja real con cientos de variaciones. En este lote, el modelo distinguió correctamente los casos según la referencia preparada. Validar esos criterios exige probar más situaciones. El modelo responde a lo que le preguntas: si le preguntas mal, responde mal.
3. Curación de fuentes de investigación (pilotado)
Al preparar este mismo reportaje, recopilé señal social con Last 30 Days. Jev clasificó los 39 fragmentos resultantes en cinco tipos: resultado reportado, demo/código, propuesta, opinión e información insuficiente.
La salida está en un CSV con enlace a cada fuente y su nivel de confianza. Como agrupación auxiliar, útil. Como sustituto del criterio del investigador, ni de lejos. Jev clasifica el texto que recibe, no abre los enlaces ni verifica las fuentes originales. Más sobre las trampas de este uso en la sección de investigación.
4. Revisar afirmaciones de informes (probado)
8 afirmaciones sobre los resultados de nuestras propias pruebas, contrastadas con un resumen de evidencia preparado de antemano. Ejemplo: "Jev reducirá a la mitad las horas de cualquier agencia". Jev la rechazó como no demostrada.
También rechazó "identifica perfectamente la intención de compra en español" y marcó como contradicción la afirmación de haber medido ambos modelos bajo condiciones equivalentes. Esa comparación no se hizo. 8 de 8 coincidencias con la referencia provisional.
Es un lote pequeño y preparado, pero enseña algo valioso: puedes usar Jev como filtro de coherencia entre lo que un informe dice y la evidencia que tiene detrás. La receta oficial de verificación de citas de TypeSafe profundiza en este patrón.
5. Solapamiento editorial (propuesto)
Antes de escribir un artículo nuevo: ¿ya existe uno que cubra lo mismo? La entrada sería el titular más un resumen de la pieza nueva, junto a los titulares y resúmenes de las páginas candidatas del blog. Jev devuelve "nueva", "actualización" o "revisar".
No lo he probado con datos reales del blog, pero el diseño encaja como paso previo en cualquier flujo editorial donde el catálogo crezca más rápido que la memoria del equipo. Lo importante: hace falta comparar las páginas reales, no solo los titulares. Un titular parecido puede cubrir un ángulo completamente distinto.
6. Preselección de clips de vídeo (propuesto, con referencia externa)
Eric Siu presenta un uso parecido en su vídeo sobre Jev para trabajo de marketing: evaluar segmentos de transcripción y decidir si la idea está completa, es un gancho potencial o depende del contexto visual. La entrada es la transcripción segmentada con contexto del episodio.
El límite es claro: seleccionar texto no equivale a montar un clip. La edición de vídeo necesita imagen, audio y ritmo que Jev no evalúa. Pero como primer filtro para reducir una hora de grabación a los momentos que merecen revisión manual, tiene sentido.
Las otras 12 propuestas (sin probar)
El catálogo completo incluye 18 aplicaciones. Las 12 que no aparecen arriba no están probadas: son diseños de entrada, decisión y límite que requerirían validación con datos reales antes de afirmar nada sobre su utilidad.
| Aplicación | Qué decide Jev | Qué vigilar |
|---|---|---|
| Encaje de leads | Encaje con ICP y ruta de revisión | No usar datos ausentes como hechos |
| Intención comercial | Compra, comparación, investigación o soporte | Acuerdo con ventas real |
| Voz del cliente | Objeción, deseo, fricción o alternativa | Consistencia entre revisores |
| Señales de baja | Problema puntual o intención de abandono | Falsas alarmas de abandono |
| Comentarios de campaña | Duda, queja, intención de compra u otro | Contexto conversacional |
| Intención de consultas SEO | Intención y necesidad de la consulta | No confundir etiqueta con volumen |
| Control del briefing | Cumple, falta información o contradice | Evidencia por cada requisito |
| Inventario de anuncios | Tipo de oferta, CTA, objeción y fase | No predecir ROAS sin datos |
| Formatos creativos | Formato candidato para la idea | Criterio de marca fuera del modelo |
| Clasificar comentarios de creatividades | Texto, imagen, oferta, marca o medición | Comentarios con varias dimensiones |
| Enrutar encargos internos | Equipo asignado o aclaración necesaria | Reglas de disponibilidad |
| Oportunidades de contenido | Pregunta recurrente o caso aprovechable | Criterio del autor antes de publicar |
Cómo Jev ha participado en esta investigación
Para preparar este reportaje recopilé 49 URLs de fuentes distintas (GitHub, Hacker News, Reddit, YouTube). Jev clasificó los 39 fragmentos con texto suficiente en cinco categorías: resultado reportado, demo/código, propuesta, opinión e información insuficiente.
La revisión posterior mostró por qué no basta con el texto que le llega. La issue de Omi en GitHub quedó clasificada como demo/código porque contiene código de ejemplo. Pero su estado de adopción real es una propuesta abierta, no una integración desplegada. Puede tener código y seguir siendo una idea.
También detecté que algunos resúmenes del motor de búsqueda mezclan comentarios de usuarios con el cuerpo del hilo. Jev clasifica lo que recibe, no abre los enlaces ni certifica la fuente original. Si el resumen mezcla cosas, la clasificación hereda esa mezcla.
Este uso sirvió como agrupación auxiliar. No se midió ahorro de tiempo y ninguna fuente se descartó automáticamente por lo que Jev dijera. El criterio final fue humano.
Jev con GBrain y los límites de la memoria de IA
Donde más jugo le he sacado a Jev es valorando fragmentos recuperados de una memoria de IA: separar evidencia útil de ruido, señalar contradicciones y decidir si un fragmento basta para responder o hace falta buscar más. La receta oficial de RAG de TypeSafe describe exactamente ese patrón.
Lo probé con 16 casos autorizados: 8 fragmentos de recuperación (RAG) y 8 afirmaciones contrastadas con evidencia. Modelo jev-1.13.0. Mediana: 0,385 segundos. Coste estimado: 0,000383 USD por los 16 casos. Coincidencia con la referencia provisional: 8/8 en RAG y 8/8 en afirmaciones.
Pero ojo. El fragmento R3 era real pero incompleto: un trozo de una nota que no contenía la información necesaria. El fragmento R-full era un resumen preparado de antemano a partir del informe completo. No son dos recuperaciones automáticas equivalentes. R3 llegó tal como llegaría de un sistema real de búsqueda; R-full es una condición enriquecida a mano.
Si trabajas con búsqueda semántica o memoria de IA, grábate esto: un clasificador posterior no arregla la ausencia de evidencia. Si lo que recuperas no contiene la respuesta, clasificarlo mejor no va a inventar el dato que falta. El sistema necesita poder abrir la nota completa, recuperar otra sección o reformular la búsqueda. Filtrar más no implica saber más.
Algunas decisiones correctas tuvieron confianza moderada (por ejemplo, 0,44 en un caso). No hay que convertir esas cifras en un umbral automático escogido después de ver los resultados: eso es sobreajustar a 16 casos.
Cuánto cuesta Jev y a qué velocidad responde
La tarifa publicada por TypeSafe a fecha de este reportaje es de 0,042 USD por millón de tokens de entrada, con la salida gratuita. Son condiciones observadas en la publicación oficial del lanzamiento, no una garantía de tarifas futuras.
Estos son los costes y latencias que he medido en las pruebas:
| Lote | Peticiones | Mediana | Tokens entrada | Coste estimado |
|---|---|---|---|---|
| 200 capturas (primera prueba) | 200 | 0,769 s | n/d | 0,0275 USD |
| 65 peticiones públicas | 65 | 0,399 s | 36.163 | 0,00152 USD |
| 16 verificaciones de evidencia | 16 | 0,385 s | 9.109 | 0,00038 USD |
| Total segunda tanda | 81 | 0,398 s | 45.272 | 0,00190 USD |
Todas las peticiones fueron secuenciales, desde un cliente Python y la red de esta máquina. El coste se calcula sobre el uso de tokens devuelto por la API de TypeSafe, no sobre una factura conciliada. Y no incluye el coste real de preparar los datos, programar las pruebas, ejecutar la investigación ni revisar los resultados.
Un usuario de r/AI_Agents describe aproximadamente un segundo por decisión frente a 4 a 14 segundos de un LLM con salida estructurada. Faltan detalles suficientes para convertirlo en una referencia, pero coincide con el orden de magnitud de lo que he observado.
Jev frente a un LLM y las reglas de siempre
Desde el lanzamiento la pregunta se repite: "¿Jev sustituye a ChatGPT?". No. Hacen cosas distintas, y la correcta depende de qué necesitas:
| Necesidad | Primera opción que evaluar |
|---|---|
| Comparar cifras, sumar costes, verificar una cadena literal | Código determinista |
| Aplicar una taxonomía semántica a muchas entradas | Jev (con evaluación y revisión de errores) |
| Redactar, explicar, proponer texto o razonar | Modelo generativo (Claude, GPT, Gemini) |
| Buscar documentos y recuperar fuentes | Motor de búsqueda o sistema de recuperación |
| Autorizar acciones o publicar | Reglas del sistema y criterio humano |
Lo bueno viene cuando combinas varias piezas. La receta de verificación de citas de TypeSafe es ilustrativa: la existencia literal de una cita se comprueba con código (comparación de cadenas), pero la relación semántica entre la cita y la afirmación es una tarea donde Jev encaja. No hace falta pagar una llamada a un LLM para una igualdad de cadenas.
Syntax lo muestra en su vídeo: un chatbot que combina las decisiones de Jev con herramientas externas y plantillas de texto. Jev elige la acción; otro componente ejecuta. Y Sam Witteveen explora cómo un cambio mínimo en el contexto del mensaje de soporte puede alterar la categoría y la urgencia asignada. El modelo responde al texto que recibe, no a lo que el cliente "quería decir".
Lo que NO se ha hecho en estas pruebas es una comparación controlada contra un LLM o un clasificador de reglas optimizado. Las decisiones históricas y las referencias sintéticas no la sustituyen. Para afirmar ahorro o superioridad haría falta la misma muestra, etiquetas humanas, métricas de error por clase y costes del flujo completo.
Dónde falla Jev
281 peticiones y revisión manual. Esto es lo que falla o lo que el entusiasmo del lanzamiento ha inflado:
Criterios mal definidos. Si tus categorías son ambiguas o se solapan, Jev va a elegir una y seguir adelante. No te va a preguntar "oye, ¿seguro que estas opciones tienen sentido?". El caso "Presupuesto" lo demuestra: el modelo eligió ventas porque es la opción más probable dada una palabra suelta. El problema no era el modelo, sino que la entrada no tenía contexto suficiente para decidir bien.
Confianza que no es exactitud. Una confianza de 0,9 significa que Jev concentra la probabilidad en esa opción, no que acierte el 90% de las veces en tu negocio. Noul, además, no incorpora el mismo campo de confianza que Choice y Score. Automatizar decisiones con un umbral escogido después de ver un lote pequeño es sobreajuste disfrazado de ingeniería.
Evidencia ausente. Jev clasifica lo que le envías. Si lo que le envías no contiene la información necesaria, la clasificación es una apuesta educada. Lo vi con los fragmentos de RAG parciales y con los resúmenes del motor de búsqueda que mezclaban cuerpo con comentarios.
No genera, no explica, no busca. Parece obvio, pero hace falta repetirlo: Jev no redacta un artículo, no escribe el email que se envía al cliente, no consulta tu CRM ni recupera documentos. Si tu flujo necesita cualquiera de esas cosas, necesitas otra pieza. Jev decide. Punto.
Lo que falta. No he medido retención, no he ejecutado una comparación controlada con un clasificador de reglas, no tengo costes del flujo completo en producción ni validación con etiquetas humanas de un equipo de marketing. Las 18 propuestas de aplicación son eso: propuestas. De las seis que he desarrollado, tres tienen datos sintéticos o preparados con lotes pequeños, una es un piloto de agrupación y dos son propuestas sin datos reales. Ninguna tiene resultados de producción.
Que tome decisiones útiles tan rápido y barato. Eso prometía Jev y eso es lo que he visto en estos lotes acotados. No es el futuro del marketing ni va a sustituir al criterio de tu equipo. Es una pieza barata y rápida para un tipo de trabajo concreto. Y lo que hace, lo puedes medir. Lo interesante empieza cuando dejas de preguntar qué hace Jev y empiezas a preguntarte cuántas decisiones de tu negocio estás pagando de más.
Preguntas frecuentes sobre Jev de TypeSafe AI
¿Jev de TypeSafe AI es open source?
No. Jev es un modelo propietario que se ejecuta en los servidores de TypeSafe a través de su API. Los SDK de Python y TypeScript son públicos, pero el código de entrenamiento, los pesos y la arquitectura interna no están disponibles. Existen proyectos comunitarios (como hermes-jev-skills o typesafe-router) que integran Jev en sus flujos, pero no son el modelo en sí.
¿Necesito saber programar para probar Jev?
Necesitas acceso a la API de TypeSafe y un entorno donde ejecutar Python o TypeScript. Si usas un asistente de código como Claude Code o Cursor, puedes pedirle que instale el SDK y lance una prueba sin escribir código tú mismo. La guía de inicio rápido oficial documenta los pasos en menos de diez líneas de código.
¿Qué significa la puntuación de confianza que devuelve Jev?
La confianza (confidence) en Choice y Score se calcula a partir de la distribución de probabilidad entre las opciones: indica cuánto concentra Jev la probabilidad en la opción elegida, no la tasa de acierto real en tu caso de uso. Noul, la primitiva de sí/no, no incorpora el mismo campo. Usar estos números como umbral automático requiere evaluación con tus propios datos, no extrapolación de un lote ajeno.